Resumen ejecutivo
La medicina ha acumulado durante siglos un cuerpo extraordinariamente amplio de conocimiento científico. Sin embargo, gran parte de ese conocimiento continúa expresándose mediante textos, documentos, clasificaciones y sistemas de información que no siempre permiten establecer relaciones computacionales directas entre sus componentes.
Paralelamente, la práctica clínica genera enormes cantidades de información sobre pacientes, enfermedades, tratamientos y resultados. Esta información suele encontrarse distribuida entre expedientes narrativos, resultados de laboratorio, imágenes, formularios y sistemas institucionales heterogéneos.
Los avances recientes en inteligencia artificial han ampliado considerablemente la capacidad de interpretar y procesar información médica no estructurada. No obstante, la interpretación probabilística del lenguaje y la representación persistente, verificable y reutilizable del conocimiento constituyen problemas tecnológicos diferentes.
KatavMD nace de la propuesta de integrar ambas capacidades: el conocimiento biomédico estructurado y la interpretación asistida por inteligencia artificial.
Desarrollado por Neora Systems, KatavMD es una infraestructura tecnológica orientada a representar conocimiento médico mediante un grafo biomédico computable, conectar ese conocimiento con observaciones clínicas individuales y facilitar progresivamente el análisis de casos, cohortes e información sanitaria.
Su arquitectura contempla tres componentes fundamentales:
- Biomedical Knowledge Graph (KG): representación estructurada del conocimiento biomédico general.
- Patient Graph (PG): modelo para organizar observaciones, eventos y estados clínicos individuales.
- Case Builder: sistema de interpretación y estructuración de información clínica mediante procesamiento híbrido.
Sobre esta infraestructura se desarrollan interfaces y motores especializados para exploración biomédica, análisis clínico e investigación.
La primera aplicación pública prevista es KatavMD Atlas, una herramienta visual que permite explorar conceptos médicos y sus relaciones mediante diagramas generados a partir del conocimiento estructurado.
Las capacidades de análisis individual, seguimiento longitudinal, investigación de cohortes e interoperabilidad institucional forman parte de la evolución prevista de la plataforma y se encuentran en diferentes etapas de desarrollo.
KatavMD no pretende sustituir el criterio médico ni reemplazar los sistemas existentes de historia clínica electrónica. Su propósito es desarrollar una capa complementaria de conocimiento computable que facilite la interpretación, organización y exploración de información biomédica.
Estado de los componentes en octubre de 2026
| Componente | Estado |
|---|---|
| Knowledge Graph biomédico | Implementado en PostgreSQL y consultable mediante herramientas internas. Su cobertura y revisión siguen creciendo. |
| KatavMD Atlas | Prototipo local navegable; primera beta pública en preparación, con cobertura inicial seleccionada. |
| Patient Graph y Case Builder | Diseño e implementaciones experimentales en desarrollo; no disponibles como servicio clínico público. |
| Research Engine e integraciones institucionales | Capacidades proyectadas sujetas a desarrollo, pilotos y validación. |
1. El desafío: conocimiento médico e información clínica fragmentados
1.1. La evolución del conocimiento médico
Desde sus primeras formulaciones sistemáticas hasta la medicina contemporánea, el conocimiento médico ha evolucionado mediante observación clínica, investigación experimental, desarrollo tecnológico y revisión científica.
Este proceso ha generado múltiples disciplinas, terminologías, sistemas de clasificación y métodos de documentación.
Aunque existen esfuerzos internacionales de estandarización, la información biomédica continúa presentando diferencias terminológicas, estructurales y contextuales entre especialidades, instituciones y países.
Un mismo fenómeno clínico puede describirse mediante expresiones diferentes, mientras que conceptos relacionados pueden aparecer distribuidos entre documentos y categorías independientes.
Estas diferencias dificultan la integración automática de información y la comparación sistemática de registros procedentes de distintas fuentes.
1.2. El problema de los registros clínicos
La información producida durante la atención médica suele combinar elementos estructurados y no estructurados.
Entre ellos se encuentran narrativas clínicas, diagnósticos, hallazgos del examen físico, mediciones de laboratorio, informes de imágenes y registros longitudinales.
Los sistemas electrónicos de salud han mejorado significativamente la disponibilidad y organización de estos datos. Sin embargo, digitalizar un documento no equivale necesariamente a convertir todo su contenido en información semánticamente estructurada y comparable.
Una descripción clínica puede contener información relevante que permanece dentro de un campo de texto y que no resulta directamente accesible para análisis estadístico sin procesamiento adicional.
Este problema adquiere especial importancia cuando se pretende estudiar información acumulada a lo largo del tiempo o procedente de múltiples pacientes e instituciones.
1.3. Inteligencia artificial y persistencia del conocimiento
Los modelos de lenguaje han demostrado capacidades importantes para interpretar narrativas, extraer información y facilitar el acceso al conocimiento médico.
Sin embargo, sus respuestas pueden variar según el contexto, la formulación de la consulta y las características del modelo utilizado.
Por esta razón, KatavMD distingue entre dos funciones:
Interpretar información mediante inteligencia artificial y representar conocimiento mediante estructuras persistentes y explícitas.
Los modelos de IA pueden colaborar en la interpretación y transformación de información, mientras que el Knowledge Graph proporciona un marco canónico de conceptos y relaciones sobre el cual pueden aplicarse controles de integridad, trazabilidad y consistencia.
Esta separación constituye uno de los principios fundamentales de la arquitectura.
2. La propuesta de KatavMD
KatavMD propone una infraestructura de conocimiento biomédico computable que permita conectar tres dimensiones:
- El conocimiento médico general.
- Las observaciones clínicas individuales.
- El análisis de información clínica y poblacional.
La propuesta no consiste únicamente en almacenar conceptos médicos ni en generar respuestas mediante inteligencia artificial.
Consiste en establecer un sistema donde los conceptos biomédicos tengan identidades canónicas y puedan relacionarse mediante conexiones explícitas, permitiendo que las observaciones clínicas se vinculen con ese conocimiento.
Esto busca facilitar la reutilización de información estructurada, la exploración de mecanismos y el desarrollo de herramientas de investigación.
2.1. Principios arquitectónicos
Persistencia: el conocimiento estructurado se conserva independientemente de las sesiones de interpretación mediante IA.
Identidad canónica: los conceptos se organizan mediante identificadores que permiten referenciarlos de manera consistente.
Relaciones semánticas: las conexiones representan tipos específicos de relación biomédica y no solamente asociaciones genéricas.
Composicionalidad: los componentes del conocimiento pueden reutilizarse en distintas representaciones clínicas.
Separación entre conocimiento y observación: las afirmaciones médicas generales se distinguen de los hechos documentados sobre pacientes individuales.
Extensibilidad: la arquitectura está diseñada para incorporar nuevas entidades, relaciones y dominios de conocimiento.
Trazabilidad: se busca conservar la procedencia y el contexto necesarios para revisar e interpretar la información.
Estos principios orientan el diseño de KatavMD, aunque su implementación y validación continúan evolucionando.
3. Biomedical Knowledge Graph
3.1. Representación computable del conocimiento
El Biomedical Knowledge Graph es el núcleo conceptual de KatavMD.
Se trata de una representación biomédica orientada a mecanismos, construida mediante entidades canónicas y relaciones semánticamente tipadas, con persistencia implementada sobre infraestructura de bases de datos relacionales.
El KG integra diferentes niveles de organización médica, entre ellos:
- Anatomía.
- Histología y biología celular.
- Fisiología.
- Fisiopatología.
- Receptores y mecanismos biomoleculares.
- Farmacología.
- Semiología.
- Entidades clínicas y relaciones entre enfermedades.
El propósito es representar conexiones entre estos dominios mediante una estructura que pueda ser consultada y procesada computacionalmente.
3.2. Ejemplo anatómico
Una estructura anatómica puede representarse como una entidad con identidad propia y relaciones explícitas hacia otras estructuras.
Por ejemplo, el árbol arterial puede organizarse mediante conexiones entre segmentos vasculares, ramificaciones y regiones anatómicas.
De manera similar, las estructuras musculoesqueléticas pueden relacionarse mediante inserciones, articulaciones y otras conexiones anatómicas.
La utilidad de esta representación no reside solamente en enumerar estructuras, sino en conservar las relaciones que permiten comprender su organización.
3.3. Ejemplo fisiológico y farmacológico
Un receptor biomolecular puede conectarse con ligandos endógenos, agentes farmacológicos y procesos fisiológicos relacionados.
De esta forma, un mismo concepto puede participar en múltiples rutas sin necesidad de duplicar su definición canónica.
La representación permite explorar conexiones entre procesos fisiológicos y mecanismos de intervención farmacológica, dentro de la cobertura y condiciones registradas en el KG.
3.4. De la fisiología a las entidades clínicas
Uno de los objetivos de KatavMD es conectar mecanismos biomédicos generales con entidades clínicas.
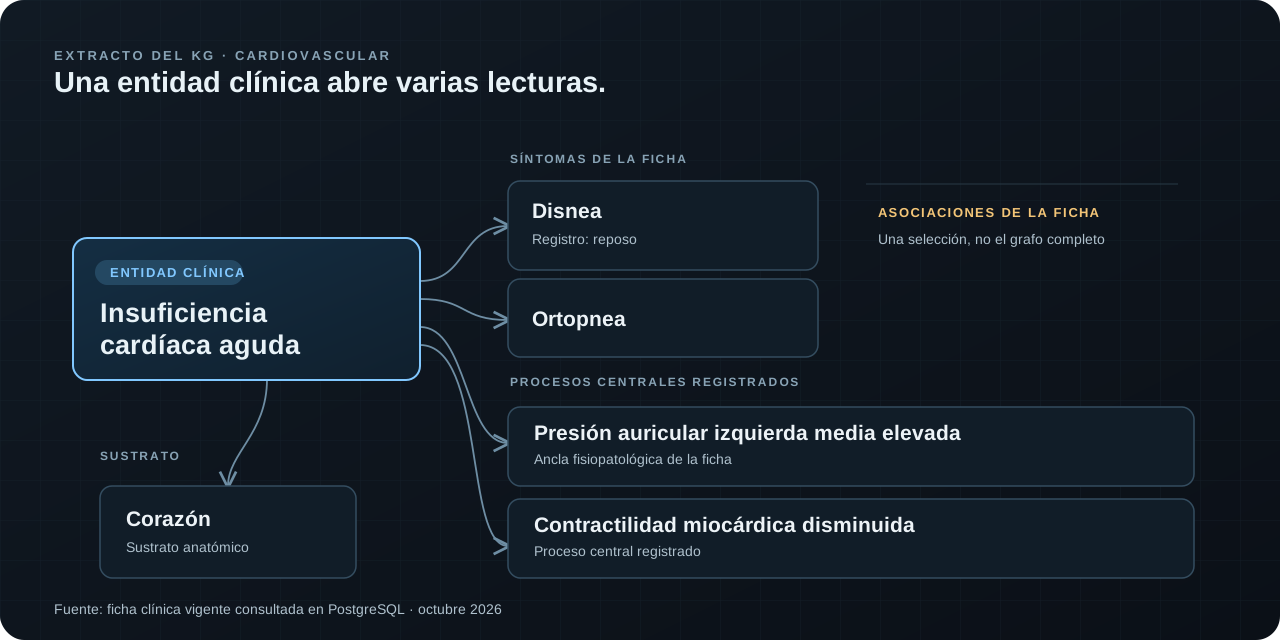
Una enfermedad puede vincularse con alteraciones fisiopatológicas, estructuras anatómicas, manifestaciones clínicas y otras enfermedades relacionadas.
Esto permite construir proyecciones clínicas a partir de componentes previamente representados.
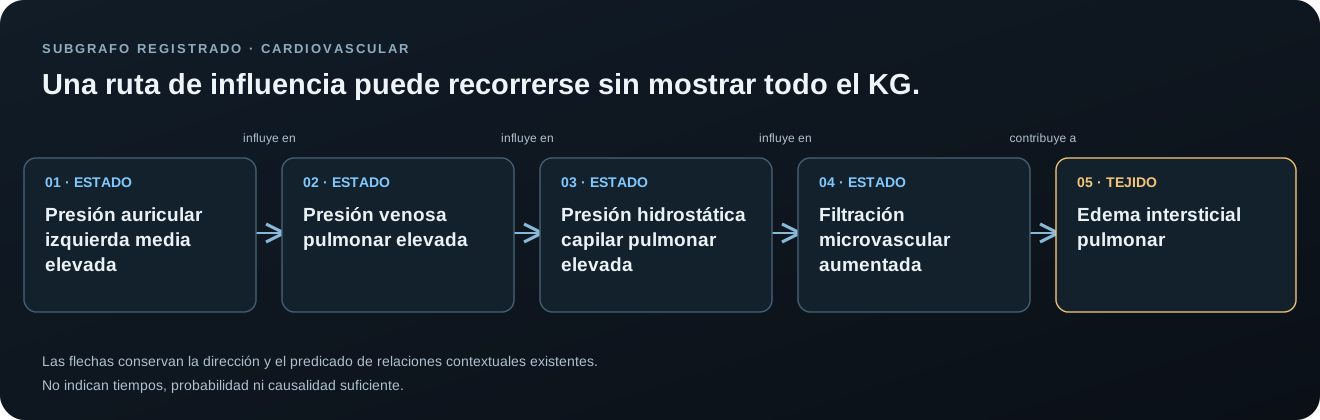
No obstante, una relación almacenada no implica automáticamente causalidad, frecuencia, secuencia temporal ni aplicabilidad universal.
Las conexiones deben interpretarse según sus predicados, condiciones y contexto.
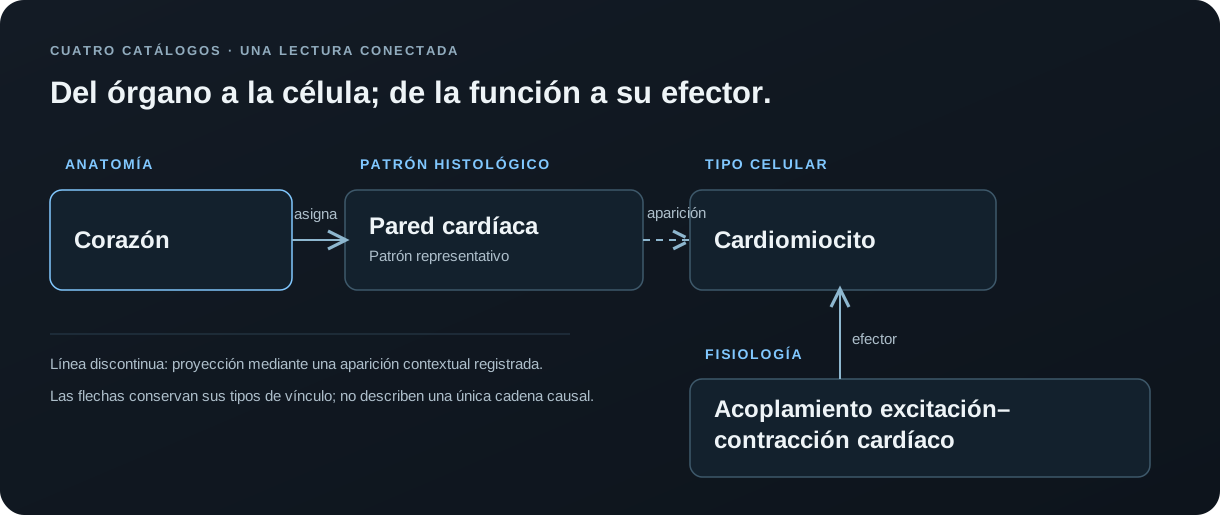
Un recorte concreto del KG muestra al corazón vinculado con un patrón histológico de pared cardíaca y una aparición de cardiomiocito; por otra relación, el cardiomiocito participa como efector en el acoplamiento excitación–contracción. La vista conjunta ayuda a explorar niveles distintos de organización, pero no convierte esas conexiones en una cadena causal universal. Las figuras de este documento simplifican las etiquetas para lectura pública y conservan esa distinción en sus pies.
4. Patient Graph: del conocimiento general al individuo
El conocimiento médico describe fenómenos generales, mientras que la práctica clínica registra observaciones sobre personas concretas.
Estas dimensiones requieren representaciones diferentes.
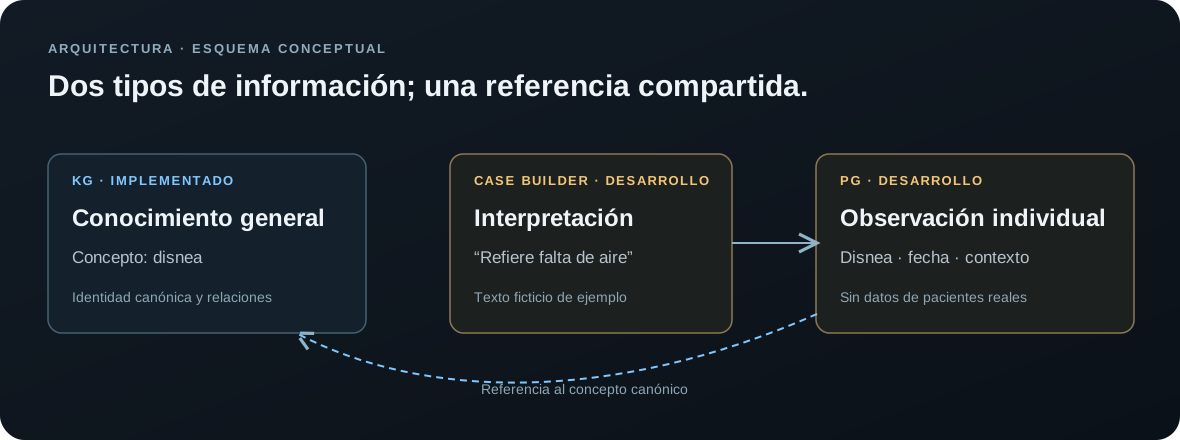
El Patient Graph (PG) es el componente diseñado para organizar observaciones, eventos, mediciones y estados clínicos individuales, utilizando referencias hacia los conceptos canónicos del Knowledge Graph.
4.1. Conocimiento general y observación individual
El KG puede representar una enfermedad que afecta una estructura anatómica.
El PG debe permitir registrar cómo esa enfermedad se manifiesta en un individuo específico.
Por ejemplo, una entidad clínica puede relacionarse con el riñón como estructura anatómica general, mientras que una observación individual puede necesitar especificar lateralidad, fecha, severidad, procedencia y grado de certeza.
La separación entre KG y PG permite preservar estas diferencias sin duplicar indiscriminadamente el conocimiento biomédico general.
4.2. Dimensión longitudinal
La arquitectura del PG contempla la representación de múltiples observaciones y eventos a lo largo del tiempo.
Esto permitiría, una vez implementadas y validadas las funciones correspondientes, estudiar la evolución de variables clínicas, comparar episodios y examinar patrones longitudinales.
4.3. Privacidad por diseño
KatavMD está orientado a utilizar información clínica minimizando la necesidad de identificadores personales.
Su modelo contempla la posibilidad de representar casos mediante identificadores seudónimos y datos clínicos adecuadamente desidentificados.
La ausencia de nombres u otros identificadores directos no garantiza por sí sola anonimización completa.
Por ello, las funciones que procesen información clínica real requerirán controles de privacidad, autorizaciones y mecanismos de seguridad acordes con el tipo de datos y su finalidad.
El Patient Graph no está concebido inicialmente como un sustituto de los expedientes clínicos electrónicos institucionales.
5. Case Builder: interpretación y estructuración clínica
El Case Builder es el componente diseñado para transformar información clínica expresada en lenguaje natural en representaciones estructuradas compatibles con el Patient Graph.
Su arquitectura combina procesamiento determinístico, vocabulario controlado y técnicas de inteligencia artificial.
El objetivo es facilitar la identificación de conceptos médicos documentados y su correspondencia con entidades canónicas.
5.1. El problema de la narrativa clínica
Una historia clínica puede describir un mismo fenómeno mediante múltiples expresiones, abreviaturas o estructuras narrativas.
Además, puede incluir negaciones, incertidumbre, antecedentes, observaciones actuales y referencias a distintos momentos temporales.
Convertir esa narrativa en información estructurada exige distinguir estos elementos y conservar su significado clínico.
5.2. Procesamiento híbrido
KatavMD explora una metodología en la que los modelos de IA colaboran con reglas y contratos computacionales para identificar y organizar información clínica.
El resultado esperado es una representación estructurada que pueda revisarse, corregirse y vincularse con el conocimiento canónico.
Esta aproximación busca reducir la dependencia de interpretaciones libres y favorecer resultados verificables.
5.3. Estado de desarrollo
El Case Builder se encuentra en desarrollo y evaluación experimental.
Su capacidad para interpretar diferentes formatos, especialidades y narrativas clínicas no debe considerarse universal ni completamente validada.
Las funciones de procesamiento de casos reales estarán sujetas a controles de privacidad y seguridad adecuados.
6. Aplicaciones de KatavMD
La arquitectura contempla cinco familias principales de aplicaciones.
6.1. KatavMD Atlas: exploración visual del conocimiento médico
Estado: primera aplicación pública prevista para Beta 1.0.
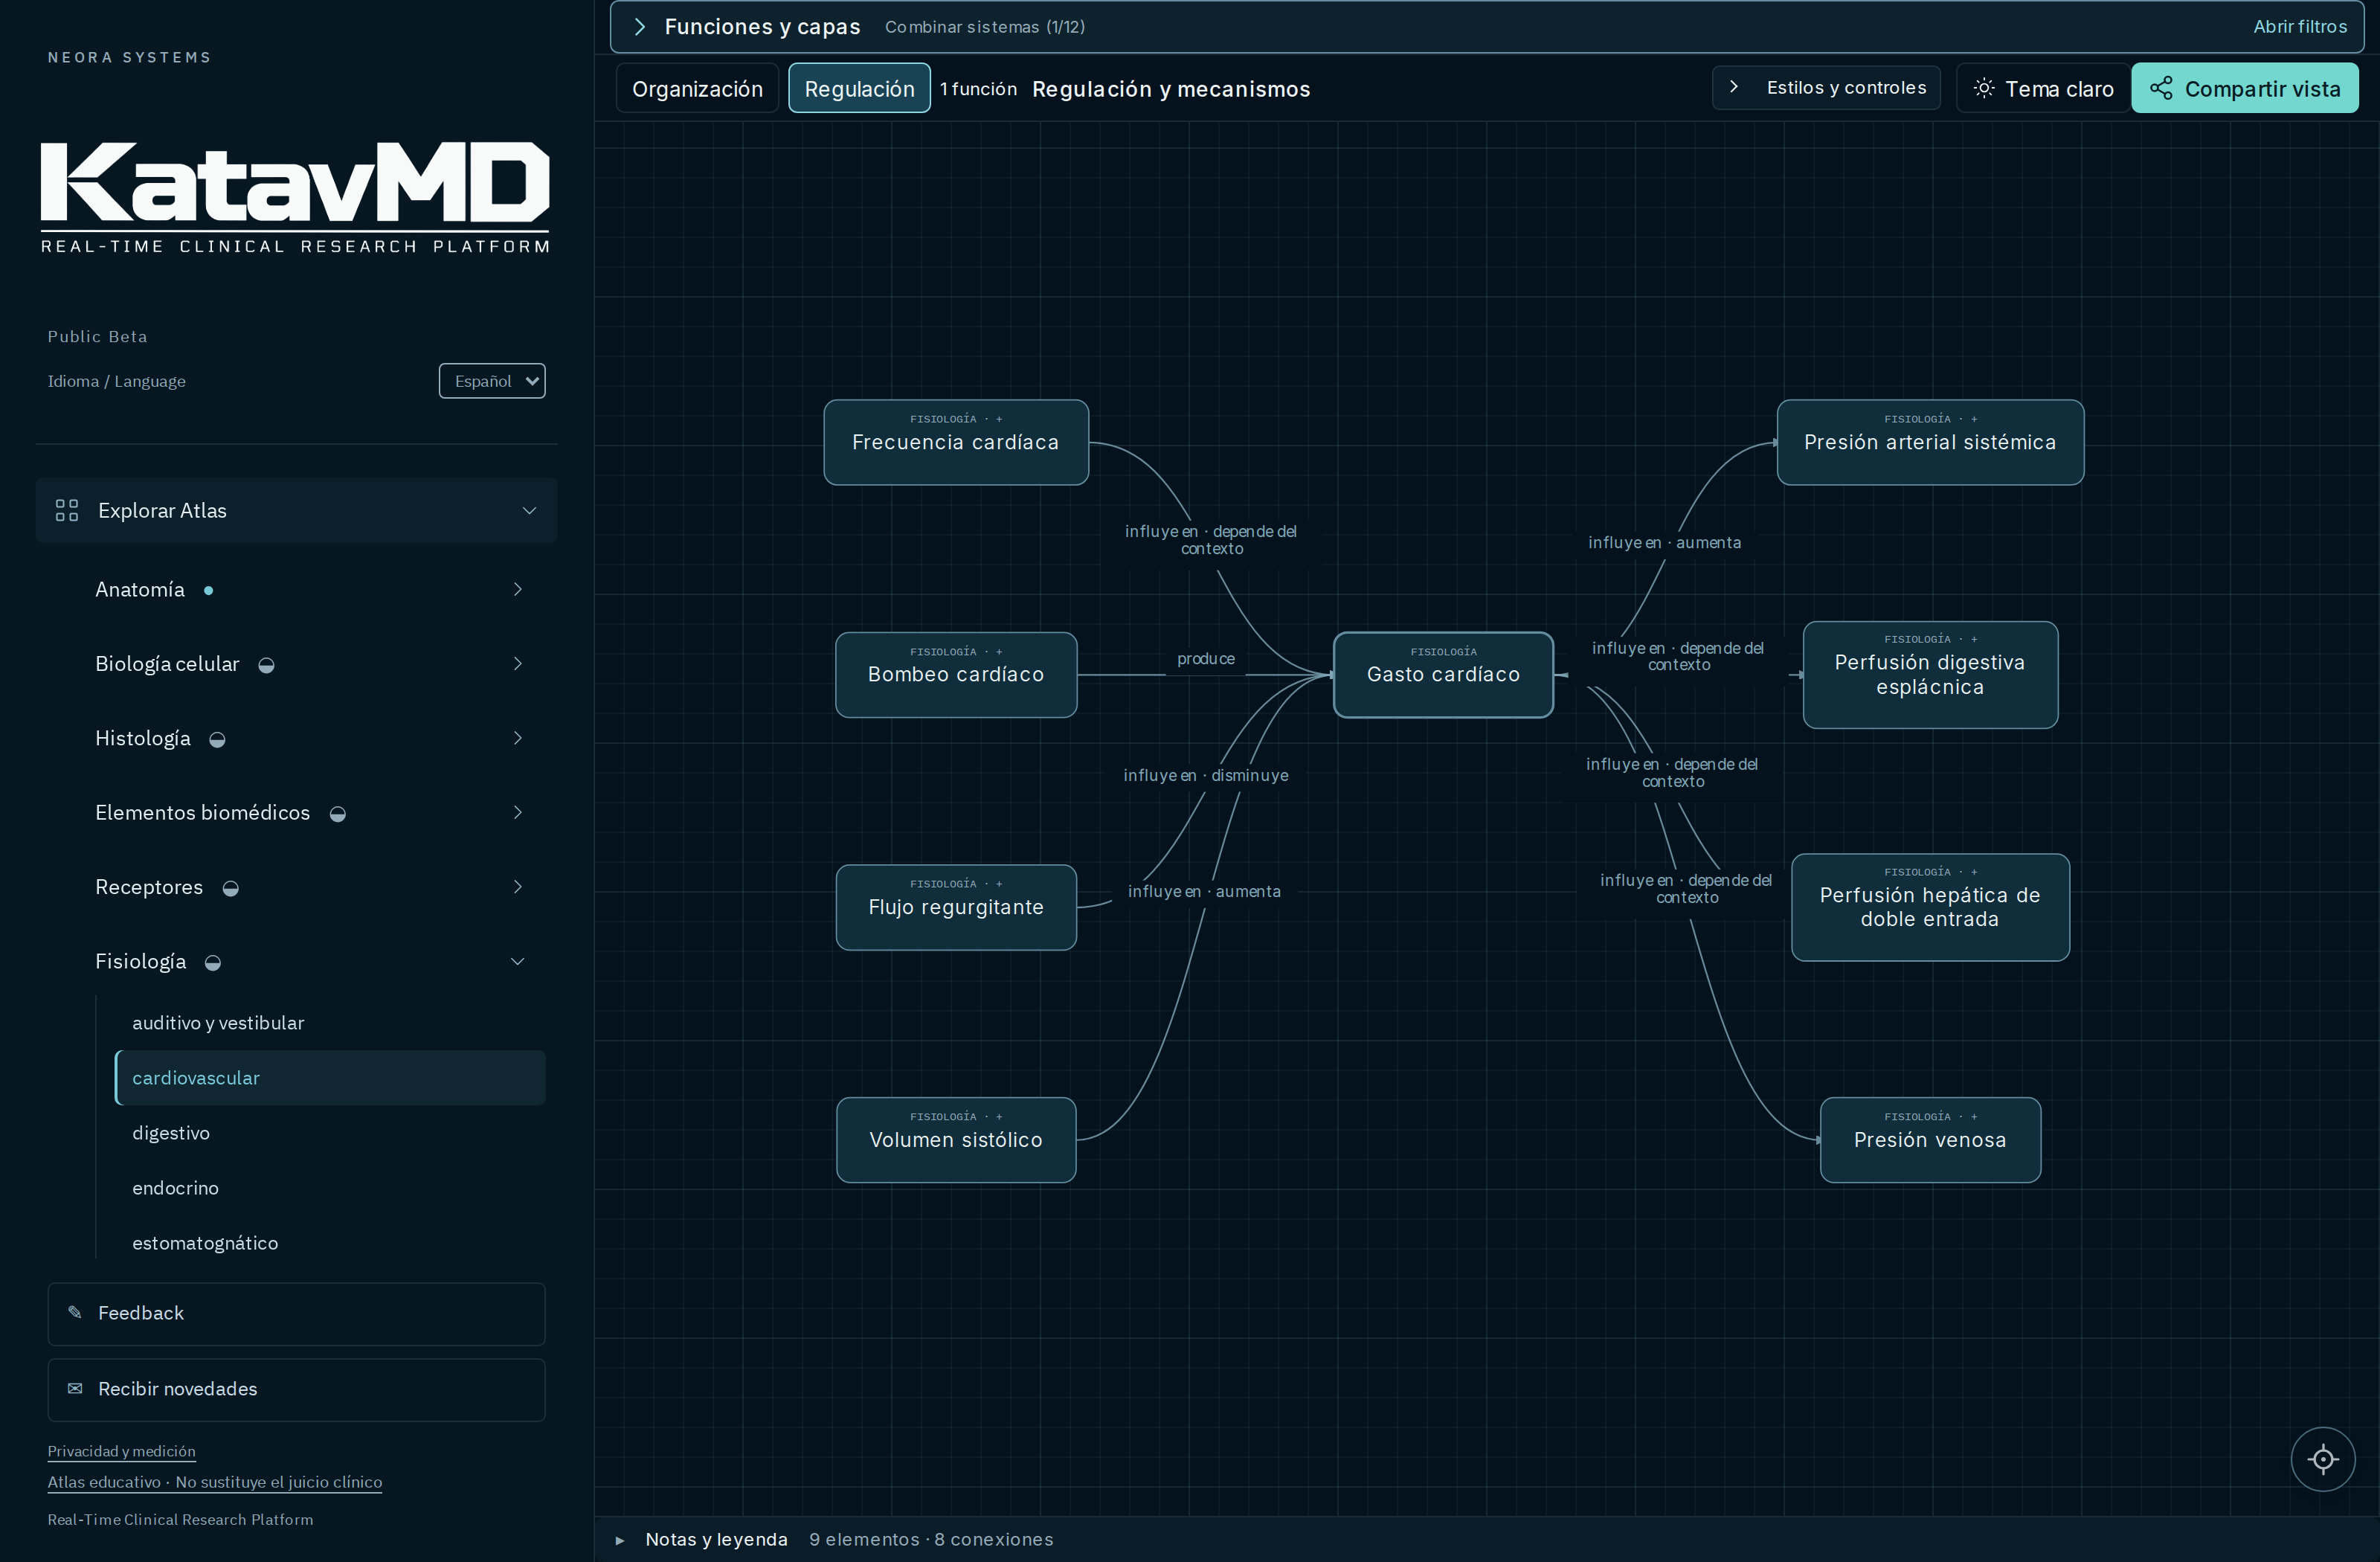
KatavMD Atlas está diseñado para representar visualmente conceptos biomédicos y sus relaciones mediante diagramas generados a partir del KG. Existe un prototipo local navegable; la versión pública beta está en preparación.
Su objetivo es facilitar la exploración de estructuras, mecanismos y relaciones clínicas en un formato navegable.
En lugar de presentar únicamente textos secuenciales, Atlas busca ofrecer perspectivas gráficas de conceptos y procesos médicos.
Las vistas pueden organizarse por temas, sistemas corporales y entidades clínicas, de acuerdo con la cobertura disponible.
La primera versión pública se concentrará en un conjunto seleccionado de representaciones reproducibles, con expansión progresiva de funcionalidades.
Atlas es una herramienta de referencia y exploración del conocimiento médico, no un sistema de diagnóstico individual.
6.2. Exploración de casos clínicos individuales
Estado: prototipo en desarrollo.
La combinación de Case Builder, Patient Graph y Knowledge Graph está diseñada para permitir la representación estructurada de casos individuales.
El objetivo es que el médico pueda examinar observaciones documentadas y explorar sus relaciones con conceptos biomédicos.
Las capacidades futuras podrían incluir perspectivas gráficas de hallazgos, mecanismos y relaciones clínicas pertinentes.
La exploración de hipótesis diagnósticas requerirá validaciones específicas y no debe interpretarse como una capacidad diagnóstica autónoma actualmente disponible.
6.3. Análisis longitudinal
Estado: funcionalidad proyectada sobre la arquitectura PG.
KatavMD contempla la organización de múltiples eventos clínicos correspondientes a un mismo individuo.
Esto podría permitir comparar episodios, estudiar cambios en variables clínicas y representar patrones temporales.
Por ejemplo, un conjunto de consultas sucesivas podría analizarse para identificar la recurrencia de manifestaciones, variaciones en mediciones y evolución de hallazgos.
La utilidad de estas funciones dependerá de la calidad, continuidad y cobertura de los registros disponibles.
6.4. Investigación clínica y análisis de cohortes
Estado: Research Engine en desarrollo.
La representación canónica de variables clínicas puede facilitar la construcción de cohortes y la ejecución de análisis reproducibles.
El Research Engine está concebido para permitir que investigadores seleccionen variables clínicas, definan poblaciones de estudio y ejecuten procedimientos analíticos sobre información autorizada.
Una de sus aspiraciones es ampliar el conjunto de variables potencialmente investigables mediante la reutilización del conocimiento previamente estructurado.
Esto podría facilitar estudios exploratorios y análisis de múltiples dimensiones clínicas.
Sin embargo, la disponibilidad de relaciones en el KG no implica que todas las variables sean observables en una cohorte ni que puedan inferirse válidamente a partir de los datos disponibles.
La interpretación estadística seguirá requiriendo controles metodológicos, evaluación de sesgos y supervisión científica.
6.5. Interoperabilidad e inteligencia institucional
Estado: aplicación institucional potencial.
KatavMD está diseñado con la intención de facilitar la organización de información clínica procedente de fuentes heterogéneas.
En un contexto institucional, una capa de estructuración y canonicalización podría complementar sistemas existentes de información sanitaria.
Entre las aplicaciones potenciales se encuentran la generación de indicadores clínicos, análisis epidemiológicos y exploración de tendencias poblacionales.
La actualización frecuente de estos indicadores dependería de las integraciones, permisos, infraestructura y calidad de los datos disponibles.
KatavMD no ha demostrado todavía interoperabilidad universal ni operación epidemiológica nacional en tiempo real.
Las integraciones institucionales requerirán pilotos y validaciones específicas.
7. Ingeniería del conocimiento y control de calidad
La construcción del Knowledge Graph ha requerido un proceso iterativo de diseño conceptual, formalización, producción de catálogos y revisión de relaciones biomédicas.
Neora Systems ha desarrollado una metodología de ingeniería del conocimiento asistida por agentes de inteligencia artificial, bajo dirección y supervisión humana.
Esta metodología combina especificaciones estructurales, vocabulario controlado, validaciones y mecanismos de auditoría interna.
El objetivo es favorecer la consistencia entre dominios y permitir la incorporación progresiva de nuevos conceptos y relaciones.
7.1. Validaciones internas
Durante el desarrollo se han utilizado procedimientos orientados a detectar inconsistencias estructurales, referencias inválidas y problemas de integración.
También se han incorporado mecanismos de revisión del contenido biomédico y consulta de referencias.
Estos controles forman parte del proceso de ingeniería, pero no constituyen por sí solos una certificación independiente de exactitud científica.
7.2. Limitaciones del conocimiento representado
El conocimiento biomédico contiene incertidumbre, variabilidad individual, relaciones condicionadas y fenómenos que no siempre pueden reducirse a estructuras discretas.
Por ello, el KG puede presentar:
- Cobertura incompleta de determinados dominios.
- Relaciones sujetas a condiciones específicas.
- Diferencias de granularidad entre áreas médicas.
- Información que requiere interpretación contextual.
- Conceptos y relaciones pendientes de revisión o ampliación.
KatavMD está concebido como una infraestructura evolutiva y no como una representación exhaustiva y definitiva de toda la medicina.
8. Validación científica y tecnológica
La utilidad científica de KatavMD requiere evaluaciones que vayan más allá de su funcionamiento técnico.
Entre las dimensiones previstas de validación se encuentran:
Integridad estructural: consistencia de entidades, identificadores y relaciones.
Fidelidad semántica: correspondencia entre las relaciones representadas y su significado biomédico.
Exactitud de extracción: capacidad de identificar correctamente información documentada en narrativas clínicas.
Preservación de contexto: manejo de negaciones, temporalidad, incertidumbre y procedencia.
Reproducibilidad: posibilidad de recuperar resultados consistentes a partir de las mismas entradas y condiciones.
Utilidad clínica e investigativa: evaluación de si las herramientas facilitan tareas reales de exploración, estructuración o análisis.
Estas dimensiones constituyen objetivos de evaluación.
No se presentan todavía resultados de validación independiente que permitan afirmar niveles específicos de exactitud clínica, sensibilidad, especificidad o superioridad frente a herramientas existentes.
9. Privacidad, seguridad y uso responsable
KatavMD se desarrolla bajo el principio de minimización de información personal.
La exploración pública mediante Atlas no requiere introducir expedientes de pacientes.
Las futuras herramientas de casos individuales y cohortes estarán orientadas a trabajar con información clínica adecuadamente desidentificada o seudonimizada, según el contexto y los controles aplicables.
El tratamiento de información clínica real estará condicionado a los requisitos de privacidad, seguridad, autorización y gobernanza correspondientes.
9.1. Limitaciones de la anonimización
La eliminación de nombres, documentos de identidad y otros identificadores directos no garantiza necesariamente que un registro clínico sea anónimo.
Determinadas combinaciones de características demográficas, acontecimientos clínicos, fechas y condiciones poco frecuentes pueden permitir la identificación indirecta de una persona.
Asimismo, la utilización de identificadores alternativos o alias persistentes puede constituir seudonimización cuando existe la posibilidad de vincular los registros con una identidad real.
Por estas razones, KatavMD distingue conceptualmente entre anonimización y seudonimización, y contempla la necesidad de evaluar el riesgo de reidentificación según la naturaleza de los datos y su contexto de utilización.
El objetivo arquitectónico es reducir al mínimo la necesidad de procesar identificadores personales, sin asumir que dicha minimización elimina automáticamente todas las obligaciones de protección de datos.
9.2. Separación entre conocimiento biomédico y datos clínicos
La arquitectura de KatavMD distingue entre el conocimiento médico general, representado en el Biomedical Knowledge Graph, y las observaciones correspondientes a pacientes individuales, organizadas mediante el Patient Graph.
Esta separación permite que las herramientas públicas de exploración biomédica funcionen sin requerir acceso a expedientes clínicos.
También proporciona una base arquitectónica para desarrollar controles diferenciados sobre los componentes que eventualmente procesen información clínica individual.
El acceso a datos de pacientes, su persistencia, los permisos de utilización y las condiciones de procesamiento deberán establecerse de acuerdo con las funcionalidades efectivamente implementadas y los requisitos aplicables.
9.3. Procesamiento de información clínica
KatavMD contempla mecanismos destinados a facilitar la transformación de información clínica en representaciones estructuradas.
Entre las estrategias consideradas se encuentra la desidentificación previa al procesamiento remoto, incluyendo modalidades de revisión y transformación local de información cuando resulten técnicamente apropiadas.
Estas capacidades requieren desarrollo, pruebas y validación antes de considerarse mecanismos confiables de protección de datos.
La incorporación de herramientas automáticas de detección de identificadores no sustituye la necesidad de autorizaciones, controles de seguridad ni evaluación del riesgo residual.
Las funcionalidades experimentales no deberán interpretarse como una autorización general para introducir expedientes clínicos identificables.
9.4. Seguridad de la información
La arquitectura de KatavMD contempla la separación entre los componentes públicos de visualización y los sistemas internos de conocimiento y procesamiento.
El diseño de seguridad está orientado a incorporar controles de acceso, minimización de información expuesta, protección de comunicaciones, trazabilidad operativa y restricciones sobre el procesamiento de datos.
La implementación y evaluación de estos controles corresponde a cada componente y etapa de despliegue.
KatavMD no afirma disponer actualmente de certificaciones independientes de seguridad de la información o de autorizaciones regulatorias universales para procesar datos médicos identificables.
Las futuras implementaciones institucionales estarán sujetas a evaluaciones de seguridad, privacidad y cumplimiento según el contexto de utilización.
9.5. Alcance clínico y supervisión profesional
KatavMD es una infraestructura de exploración, estructuración y análisis de conocimiento e información biomédica.
Sus representaciones gráficas y relaciones computacionales no constituyen por sí mismas diagnósticos clínicos, recomendaciones terapéuticas individualizadas ni conclusiones científicas definitivas.
La existencia de una relación entre conceptos médicos no implica necesariamente causalidad, frecuencia, relevancia diagnóstica o aplicabilidad a un paciente específico.
Las funcionalidades de análisis clínico se desarrollan como herramientas de apoyo a la interpretación profesional y requieren evaluación de sus capacidades, errores y limitaciones.
KatavMD no sustituye el juicio clínico, los protocolos asistenciales ni las responsabilidades de los profesionales sanitarios.
10. Estado actual y hoja de ruta
KatavMD se encuentra en una etapa de desarrollo y validación progresiva.
Su infraestructura inicial de conocimiento biomédico ha alcanzado un nivel de desarrollo que permite generar representaciones diagramáticas de múltiples dominios médicos.
El proyecto avanza mediante una estrategia modular, en la cual las distintas aplicaciones pueden incorporarse progresivamente sin requerir que la totalidad del conocimiento biomédico esté representada desde el lanzamiento inicial.
10.1. KatavMD Atlas Beta
Primera aplicación pública prevista.
Atlas constituye la primera manifestación accesible de la infraestructura de conocimiento de KatavMD.
Su versión inicial se concentra en la exploración visual de conceptos biomédicos mediante vistas seleccionadas, generadas a partir de relaciones almacenadas en el Knowledge Graph.
El lanzamiento beta prioriza una experiencia navegable, comprensible y reproducible.
La cobertura inicial será parcial y podrá ampliarse progresivamente conforme evolucionen el conocimiento estructurado, las herramientas de visualización y los procesos de revisión.
10.2. Patient Graph y Case Builder
Componentes en desarrollo y evaluación experimental.
El Patient Graph está diseñado para representar observaciones clínicas individuales mediante referencias al conocimiento canónico.
El Case Builder busca facilitar la transformación de narrativas clínicas en estructuras compatibles con este modelo.
Las primeras implementaciones se orientan a comprobar la viabilidad de la representación, la integridad de los datos y la utilidad de los resultados.
La incorporación de nuevas modalidades de entrada y el procesamiento de registros longitudinales dependerán de su desarrollo y validación.
10.3. Research Engine
Componente en desarrollo.
El Research Engine está concebido para utilizar la información estructurada del Patient Graph y las relaciones del Knowledge Graph en procedimientos de investigación clínica.
Su desarrollo contempla mecanismos para seleccionar variables, definir cohortes y ejecutar análisis sobre datos disponibles y autorizados.
Las primeras evaluaciones buscarán establecer la factibilidad técnica, reproducibilidad y utilidad metodológica de estas capacidades.
10.4. Integraciones institucionales
Aplicación futura sujeta a pilotos y acuerdos específicos.
KatavMD contempla la posibilidad de integrarse como una capa complementaria de conocimiento y análisis sobre sistemas existentes de información sanitaria.
Las integraciones dependerán de los formatos disponibles, las políticas de acceso, la calidad de los datos, los requisitos de seguridad y las necesidades de cada institución.
No se presupone compatibilidad automática con todos los sistemas de expedientes electrónicos ni disponibilidad inmediata de análisis poblacional en tiempo real.
11. Perspectivas de investigación y desarrollo
La arquitectura de KatavMD está concebida como una infraestructura evolutiva.
Su desarrollo futuro contempla tanto la ampliación del conocimiento representado como la creación de herramientas capaces de utilizarlo para responder preguntas biomédicas.
11.1. Expansión del conocimiento
El Biomedical Knowledge Graph puede ampliarse mediante la incorporación de nuevos conceptos, relaciones y niveles de granularidad.
Entre las áreas de interés futuro se encuentran representaciones especializadas de oncología, neurociencias y otros dominios que requieran mayor detalle molecular, fisiológico o fisiopatológico.
Estas extensiones constituyen oportunidades de investigación y desarrollo, no funcionalidades actualmente disponibles.
11.2. Investigación clínica basada en variables canónicas
Una de las aspiraciones de KatavMD es facilitar que las variables representadas en el conocimiento biomédico puedan vincularse con observaciones clínicas y, cuando existan datos suficientes, utilizarse en análisis de investigación.
Este enfoque podría ampliar las posibilidades de exploración de información clínica previamente estructurada.
Sin embargo, la existencia de una variable dentro del KG no garantiza su disponibilidad en registros individuales ni su validez para cualquier análisis.
La selección de variables deberá considerar calidad de datos, contexto clínico, criterios metodológicos y limitaciones estadísticas.
11.3. Investigación poblacional y actualización de indicadores
En escenarios institucionales futuros, KatavMD podría facilitar la generación de indicadores clínicos a partir de fuentes de información actualizadas.
La frecuencia y oportunidad de dichos indicadores dependerían de las capacidades de integración, procesamiento, validación y disponibilidad de los datos.
El objetivo de largo plazo es contribuir al desarrollo de herramientas que permitan analizar información sanitaria con mayor flexibilidad y reproducibilidad.
Estas capacidades requerirán demostración mediante estudios y pilotos específicos.
11.4. Ingeniería del conocimiento asistida por inteligencia artificial
La metodología desarrollada durante la construcción de KatavMD constituye también una línea potencial de evolución tecnológica de Neora Systems.
La experiencia obtenida sugiere oportunidades para investigar procesos reproducibles de construcción, ampliación y mantenimiento de representaciones especializadas de conocimiento.
La aplicabilidad de esta metodología a otros dominios científicos deberá evaluarse de manera independiente.
12. Conclusión
La medicina contemporánea dispone de un volumen extraordinario de conocimiento científico y de información clínica.
Sin embargo, la capacidad de transformar ese conocimiento en estructuras computables, conectarlo con observaciones individuales y utilizarlo sistemáticamente para investigación continúa siendo un desafío relevante.
KatavMD propone abordar este problema mediante una arquitectura que integra conocimiento biomédico canónico, representaciones clínicas individuales y herramientas de interpretación asistidas por inteligencia artificial.
Su propuesta fundamental es separar la persistencia del conocimiento de los procesos probabilísticos de interpretación, permitiendo que ambos componentes colaboren dentro de una infraestructura estructurada.
El Biomedical Knowledge Graph constituye la base de esta arquitectura.
El Patient Graph y Case Builder están diseñados para conectar esa base con observaciones clínicas, mientras que el Research Engine contempla su aplicación futura a estudios individuales y poblacionales.
KatavMD Atlas representa el primer paso hacia la exposición pública de esta infraestructura.
Su lanzamiento beta busca permitir que profesionales sanitarios exploren visualmente el conocimiento médico, conozcan las capacidades iniciales del proyecto y participen en su evaluación y evolución.
KatavMD no se presenta como una representación definitiva de la medicina ni como una solución universal a los desafíos de la investigación clínica.
Se presenta como una infraestructura tecnológica en desarrollo, orientada a explorar nuevas formas de organizar, conectar y utilizar conocimiento biomédico.
La siguiente etapa estará determinada por la validación científica, la experiencia de los usuarios, la colaboración con profesionales e instituciones y la evaluación de aplicaciones reales.
La visión de KatavMD es contribuir a que el conocimiento médico no solamente pueda consultarse, sino también representarse, conectarse y utilizarse computacionalmente para facilitar la investigación biomédica.
Neora Systems, S.EP
Panamá · 2026
KatavMD — Real-Time Clinical Research Platform · Public Beta.
Nota sobre el estado del proyecto: Este documento describe una arquitectura tecnológica en evolución. Las capacidades identificadas como previstas, experimentales o en desarrollo no deben interpretarse como funcionalidades disponibles comercialmente. Las afirmaciones sobre utilidad científica y clínica están sujetas a evaluación y validación independiente.